Automatización logística en pymes: por dónde empezar
Qué proceso automatizar primero en una pyme de transporte, cuánto cuesta de verdad el primero y cuándo no compensa hacerlo.
 Alfonso Carmona16 de octubre de 2026 · 10 min de lectura
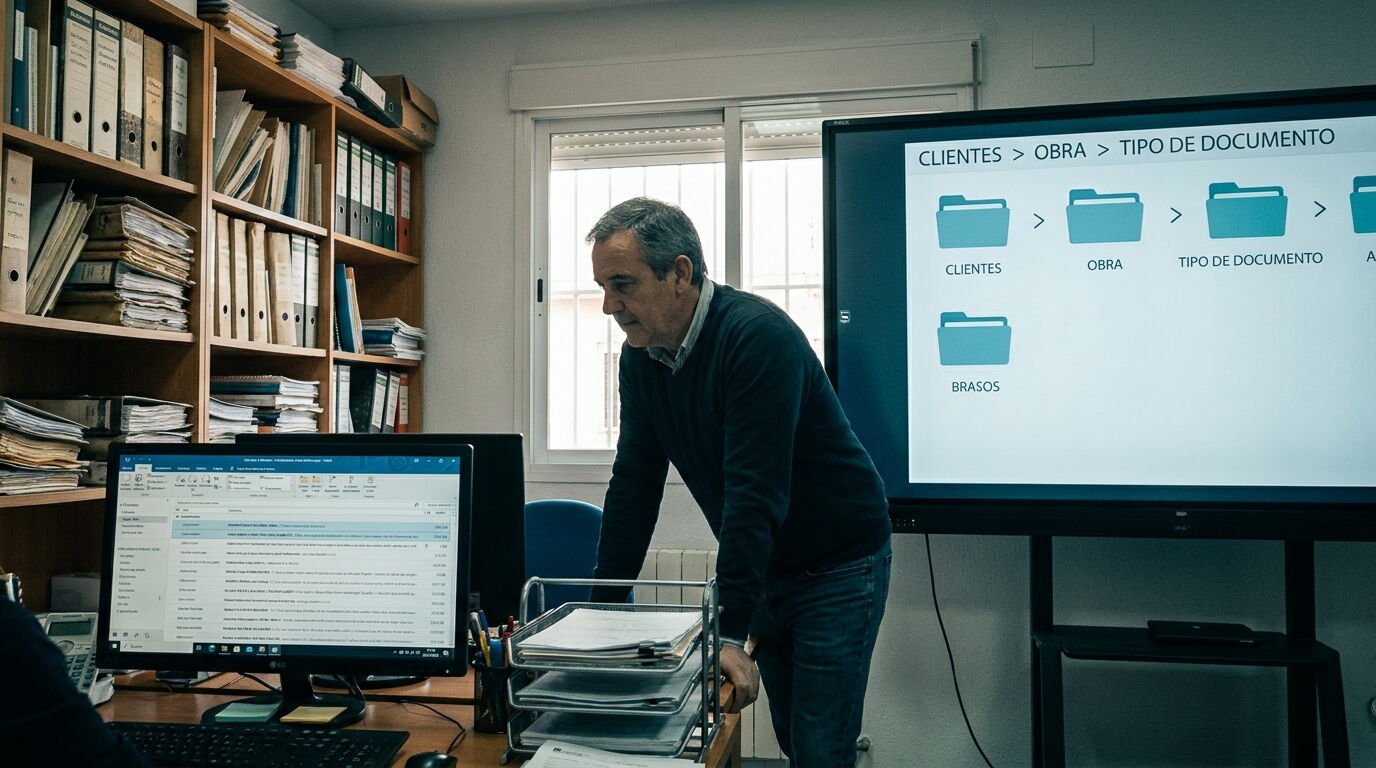
Clasificar documentos automáticamente consiste en que cada archivo que llega a la empresa reciba su nombre, su tipo y su sitio sin que nadie tenga que arrastrarlo a una carpeta. En una pyme de servicios profesionales o en una industria pequeña, eso supone dejar atrás dos costumbres. La primera es la carpeta compartida que cada uno ordena a su manera. La segunda es el adjunto que solo existe en el buzón de quien lo recibió. La parte técnica es la fácil. Lo difícil es elegir por dónde empezar.
Clasificar documentos automáticamente es que un sistema lea el contenido de cada archivo, reconozca qué tipo de documento es y lo guarde con el nombre, las etiquetas y la ubicación que ha definido la empresa. Son tres gestos que hoy hace una persona: abrir, entender y archivar. El sistema los repite igual con el primer documento del día y con el último.
La pieza de IA que hace posible ese trabajo es el análisis del lenguaje escrito. Según los indicadores de uso de inteligencia artificial del ONTSI, en 2025 fue la segunda tecnología de IA más usada por las empresas españolas que ya trabajan con IA, con un 49,6%. No necesitas saber cómo funciona por dentro. Necesitas saber qué documentos tienes y qué quieres que pase con cada uno.
Un OCR convierte la imagen de un escaneo en texto, pero no sabe si ese texto es un certificado, un parte de trabajo o una carta. El buscador del explorador de archivos encuentra lo que coincide con el nombre del fichero o con una palabra, siempre que el documento tenga texto legible. Ninguno de los dos decide nada.
Clasificar documentos automáticamente da el paso siguiente. El sistema entiende de qué va el documento, extrae los datos que importan (cliente, fecha, número de proyecto u obra) y con ellos lo nombra y lo etiqueta. El OCR suele ser la primera capa del proceso cuando el original es un papel escaneado. Si quieres ver esa capa aplicada a un caso concreto, la explicamos en la guía sobre OCR de facturas para pymes.
Las carpetas compartidas y el correo dejan de servir porque solo funcionan mientras todos archivan igual, y eso se rompe en cuanto varias personas guardan documentos con prisa. Aparecen carpetas como «Cliente nuevo definitivo 2». El mismo informe vive en tres versiones. Y los adjuntos importantes nunca salen del buzón de quien los recibió.
El coste no aparece en ninguna factura. Se nota cuando un técnico pregunta por el certificado de calibración de un equipo o cuando un cliente pide la última versión de un informe. Se nota todavía más cuando alguien se va y se lleva en la cabeza la lógica de sus carpetas. Encontrar un documento acaba dependiendo de la memoria de una persona concreta.
Usar IA para poner orden ya no es cosa de empresa grande. Según la encuesta del INE sobre uso de TIC en las empresas, en el primer trimestre de 2025 el 21,1% de las empresas españolas de 10 o más empleados usaba inteligencia artificial, 8,7 puntos más que un año antes. En el sector servicios la cifra llegaba al 25,7%.
Un archivo digital que se ordena solo recoge cada documento por una puerta de entrada única, lo lee, lo clasifica según las reglas de la empresa y lo guarda con un nombre y unas etiquetas que permiten encontrarlo después. El recorrido típico es este:
Encontrar deja de ser un ejercicio de memoria. Puedes pedir «todos los certificados de material de la obra X de 2025» y el archivo filtra por etiquetas. También puedes buscar una frase que aparece dentro de un documento escaneado. Así planteamos el servicio de gestión documental con IA para pymes: el sistema se adapta a cómo trabaja la empresa, no al revés.
La herramienta aplica las reglas. La empresa las escribe. Eso incluye el formato del nombre (por ejemplo, «2025-03-14_Cliente_Informe-inspeccion_OB118», con fecha, cliente, tipo y referencia en ese orden), la lista cerrada de tipos de documento y las etiquetas que de verdad se usan para buscar: cliente, proyecto u obra, estado. Si dejas que el sistema invente categorías, tendrás otra carpeta compartida desordenada. Solo que más rápida.
Para clasificar documentos automáticamente en una pyme no suele hacer falta entrenar un modelo propio. Basta con definir bien los tipos, las reglas de nombre y las etiquetas. Después se prueba con documentos reales antes de dejar que el sistema trabaje solo. Esas pruebas sirven para afinar las reglas, no para sustituirlas.
Una persona tiene que revisar cuando el sistema duda, cuando aparece un tipo de documento que no estaba previsto y durante las primeras semanas de uso. La regla práctica es sencilla: lo dudoso va a una bandeja de revisión, nunca a una carpeta por defecto.
Esa revisión no es tiempo perdido. Cada corrección indica qué regla falla o qué tipo de documento falta, y con ella se ajusta el sistema. Lo que no conviene es eliminar la bandeja cuando parece que todo va bien. Un documento mal archivado es peor que uno sin archivar, porque nadie lo busca donde está.
Conviene clasificar primero los documentos que llegan a menudo, con un formato parecido y que alguien busca cada semana. Los raros, los muy variados y los que ya tienen su propio flujo de trabajo pueden esperar a una segunda fase.
Los tres criterios juntos marcan al candidato ideal. El volumen alto hace que el ahorro se note pronto. El formato repetido reduce los errores. La búsqueda frecuente garantiza que el equipo vea la diferencia. En servicios profesionales suelen cumplirlos los informes entregados a clientes, los presupuestos aceptados y la documentación que el cliente envía para abrir un expediente. En industria, los partes de trabajo, los certificados de material, las fichas técnicas y los certificados de calibración.
| Tipo de documento | Volumen | Formato | Frecuencia de búsqueda | Fase recomendada |
|---|---|---|---|---|
| Partes de trabajo | Alto | Muy repetido | Semanal | Primera |
| Certificados de material y de calibración | Medio o alto | Repetido por proveedor | Auditorías e incidencias | Primera |
| Informes entregados a clientes | Medio | Plantilla propia | Alta | Primera |
| Actas de reunión | Medio | Variable | Media | Segunda |
| Facturas | Alto | Repetido | Alta | Flujo propio |
| Contratos | Bajo | Muy variable | Puntual pero crítica | Flujo propio |
| Histórico de años anteriores | Muy alto | Mezclado | Baja | Última |
La tabla es orientativa. Cada empresa debe ajustarla a lo que de verdad entra y se busca en su día a día.
En la primera fase no entran el histórico completo, los documentos que aparecen una vez al año ni los expedientes de personal, que necesitan permisos más finos antes de automatizar nada. Tampoco las facturas ni los contratos, aunque parezcan los candidatos obvios.
Ninguno de los dos se queda en archivar. Una factura hay que leerla campo a campo, cuadrarla con el pedido y llevarla a contabilidad. Es un proyecto con su propio flujo, y ahí encaja mejor una herramienta de extracción de datos que un archivo general.
Un contrato pide vigilar plazos, renovaciones y cláusulas, algo que tratamos en cómo usar IA con los contratos de proveedores en una pyme industrial. Meter ambos en la primera fase alarga el proyecto y retrasa el momento en que el equipo nota el cambio.
El error más habitual al pasar de carpetas a gestión documental con IA es querer ordenarlo todo de golpe, histórico incluido, antes de tener las reglas probadas. Detrás vienen estos cinco:
Empezar con el archivo digital de tu pyme es elegir un solo tipo de documento, escribir sus reglas y ponerlo a funcionar con lo que entra cada día antes de tocar el pasado. El orden que recomendamos:
Cuando el primer tipo funciona, el segundo cuesta mucho menos: las reglas de nombre y las etiquetas de cliente o proyecto ya están escritas. Las asesorías tienen matices propios (documentación de muchos clientes y un calendario fiscal que manda), y los recogemos en la guía de gestión documental para asesorías fiscales.
La decisión de fondo está entre ordenar poco y bien o mucho y regular. Nosotros apostamos por lo primero. Clasificar documentos automáticamente con un solo tipo bien resuelto convence más al equipo que diez tipos a medias. Si no tienes claro cuál es ese primer documento en tu empresa, el diagnóstico de IA para pymes sirve para localizarlo a partir de tus procesos reales.
En una pyme normalmente no hace falta entrenar un modelo propio. Basta con definir los tipos de documento, las reglas de nombre y las etiquetas que usa la empresa, y validar los primeros resultados con ejemplos reales. Cuando esos ejemplos salen bien clasificados, el sistema puede trabajar solo y dejar en revisión únicamente los casos dudosos.
Los documentos que el sistema no sabe clasificar van a una bandeja de revisión en lugar de archivarse a ciegas. Una persona decide dónde van, y esa corrección sirve para ajustar las reglas. Así los casos dudosos no acaban mal guardados en una carpeta por defecto.
Sí, lo que ya está en carpetas compartidas y en el correo se puede ordenar, pero conviene hacerlo por fases. Primero se clasifica lo que entra a diario. Después se migra el histórico por tipo de documento, empezando por el que más se busca y dejando para el final lo que casi nadie consulta.
Cheque TIC 2026: si tu empresa está en la Región de Murcia, el INFO paga el 70 % de automatizar procesos como este, hasta el 30 de diciembre y por orden de llegada. Requisitos y cuantías.
Dirección técnica y estrategia en Novantin. Escribo los artículos de este blog: elijo el enfoque, reviso los datos y las fuentes y apruebo lo que se publica, apoyándome en el sistema de contenidos con IA que montamos para nuestros clientes, tal y como pide el artículo 50 del reglamento europeo de IA. Cómo trabajamos · Sobre mí.
Aceptas la política de privacidad. Doble opt-in: confirma desde tu correo.
Qué proceso automatizar primero en una pyme de transporte, cuánto cuesta de verdad el primero y cuándo no compensa hacerlo.
Qué hace y qué no hace la IA en la optimización de rutas de flotas pequeñas, y cuándo pagar un optimizador deja de compensar.
Qué facturar, cerrar y medir cuando el albarán ya es digital, con horas orientativas para una pyme de transporte.